检测方案免费咨询电话
18863626387

为什么要让图像数据和干重一一对应
植物根系分析仪通过扫描或拍摄根系样品,由软件识别根系并计算根长、根表面积、根体积、根尖数量、分枝数等形态指标。烘干称重则是在根系样品完成图像采集后,经杀青、烘干至恒重,再用天平得到根干重。前者描述根系的形态和构型,后者反映生物量积累,两者结合才能回答根系长得长是否一定重、细根多是否对应更高生物量等问题。但如果图像文件和干重记录没有一一对应,后续分析就会失去基础。
从取样环节就开始编号
对应关系不是扫描时才建立的,而应从取样时开始。每个样品在清洗前就应分配唯一编号,编号要能区分处理、小区、植株、土层或根窗位置等信息。建议使用耐水标签或防水笔书写,避免在清洗、浸泡过程中字迹脱落。若一个植株的根系需要分成多个扫描件,应在编号后加后缀,例如同一植株的上层根、下层根分别标记,并在记录表中注明它们属于同一样品。这样植物根系分析仪输出多个结果文件时,仍能追溯到同一株或同一处理。
扫描与烘干的操作顺序
常规流程是:清洗根系、去除杂质、将根系摊开并避免重叠,然后进行图像采集,最后把同一编号的根系全部收集起来烘干称重。这里有两个容易出错的点。第一,扫描后剩余的小碎根要尽量收全,否则图像指标与干重的对应关系会被削弱。第二,如果根系分成多份扫描,烘干时必须合并为同一份,或分别称重后再求和。无论采用哪种方式,都应在记录中写清楚,避免后面把部分根重误当成全部根重。植物根系分析仪只负责图像端的结果,它不会知道烘干端发生了样品拆分或合并。
记录表应包含哪些字段
一张实用的对应表通常包括:样品编号、处理名称、重复号、取样部位或土层、扫描文件名称、扫描顺序、图像分析结果文件名称、烘干容器编号、称重日期、根干重、备注。扫描文件名称最好与样品编号保持一致,例如编号加扫描序号,避免使用无意义的相机默认文件名。称重时先记录容器编号和容器自重,再记录容器加根重,便于复核。对于需要分批烘干的样品,注明批次和烘干条件,能让后续追溯更清晰。
图像结果导出后的整理方法
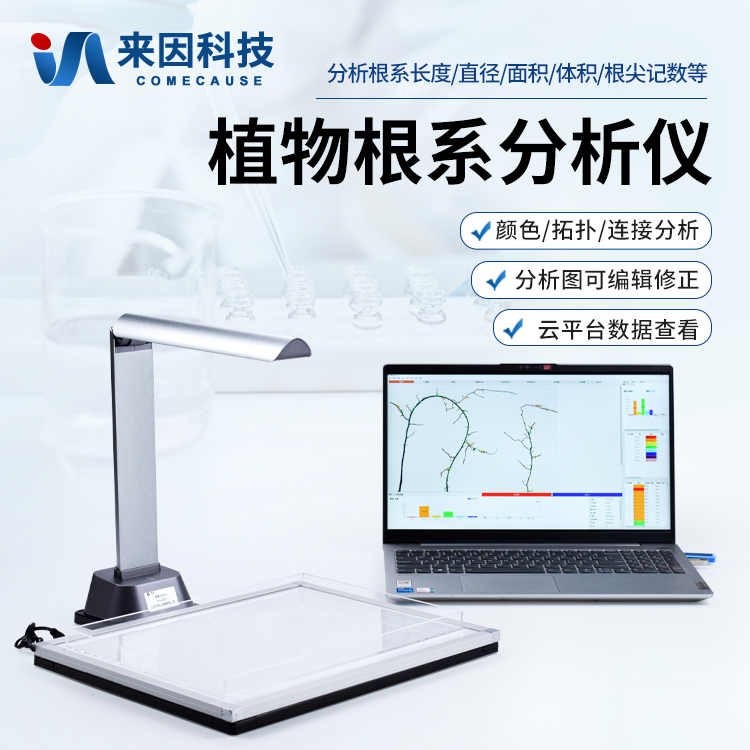
植物根系分析仪配套软件通常可以导出表格。导出后不要直接删除中间文件,建议保留原始扫描图像、软件工程文件或分析结果,并按样品编号建立文件夹。整理时先核对图像数量与记录表中的扫描件数量是否一致,再核对每个图像文件对应的编号是否唯一。若发现某个编号缺少图像或缺少干重,应在数据合并前处理,而不是等到统计分析时才发现。对于根长、根表面积等指标,可以保留软件输出的原始单位,不要随意换算,以免在后续比较中引入单位错误。
常见对应错误与排查
第一类是编号重名,两个样品使用了相同编号,导致图像与干重被错误合并。第二类是扫描顺序与称重顺序不一致,尤其在批量处理时容易把相邻样品弄混。第三类是同一植株的多个扫描件被当成独立样品,造成重复计数。第四类是清洗后根系未完全收集,图像显示根系完整,但干重偏低。排查时可以按编号、图像文件、称重记录三条线交叉核对,先看数量是否一致,再看编号是否唯一,最后抽查几个样品,确认图像中的根系形态与记录描述是否吻合。
让数据对应成为固定流程
把编号、扫描、烘干、称重、导出和核对写成固定流程,并让参与人员按同一张表记录,可以显著减少对应错误。植物根系分析仪提供的是图像端的定量信息,烘干称重提供的是生物量信息,两者只有在样品身份明确的前提下才能放在一起解释。对于长期试验,还应在每个批次结束后做一次完整性检查,确认没有遗漏样品、没有重复编号、没有孤立文件。这样积累下来的根系数据,才更便于后续比较和复用。